


SQL на пальцах для системного аналитика: какой базы хватит
Для первых учебных задач системному аналитику нужна понятная база SQL: прочитать таблицу, отобрать строки по условию, связать две таблицы и проверить, что означает результат. Начните с SELECT, WHERE, ORDER BY, INNER JOIN и LEFT JOIN, затем добавьте простые подсчёты. Этого хватит, чтобы разбирать примеры из этой статьи и проверять несложные правила на данных. Требования конкретной вакансии могут быть шире.
Представьте задачу: в личном кабинете магазина нужно показывать оплаченные заказы и имя покупателя. Аналитик уточняет поля, статусы и связи между сущностями, а с помощью SQL проверяет, какие записи должны попасть на экран. Разберём этот пример по шагам — без необходимости сначала изучать всю базу данных.
Зачем системному аналитику SQL
SQL — язык работы с данными, который используют, в частности, в реляционных базах. Такие базы хранят данные в таблицах со строками и столбцами. Система управления базой данных, например PostgreSQL, выполняет запрос и возвращает результат.
SQL для аналитика помогает отвечать на конкретные вопросы:
- Какие заказы находятся в нужном статусе?
- С каким клиентом связан заказ?
- Есть ли клиенты, у которых ещё нет заказов?
- Совпадает ли сумма на экране с данными, которые мы проверяем?
Допустим, в требованиях написано «показать активные заказы». До запроса придётся выяснить, какие статусы считать активными. SQL помогает проверить согласованное правило, а само определение «активного заказа» нужно получить от бизнеса и зафиксировать в требованиях.
Если вы знакомитесь с профессией, сначала полезно понять, можно ли стать системным аналитиком с нуля. SQL — часть технической базы наряду с требованиями, моделированием и интеграциями.
Какой SQL нужен аналитику на старте
Ниже — практический ориентир для начала обучения. Это не универсальный список требований всех работодателей.
| Что освоить | Что вы сможете сделать |
|---|---|
| Таблицы, типы данных, первичные и внешние ключи | Понять, что хранится в поле и как связаны записи |
SELECT, FROM, WHERE | Выбрать нужные столбцы и строки |
AND, OR, IS NULL | Составить условие и проверить отсутствие значения |
ORDER BY, ограничение числа строк | Получить упорядоченный фрагмент результата |
INNER JOIN, LEFT JOIN | Связать таблицы и увидеть записи без соответствия |
COUNT, SUM, GROUP BY | Посчитать строки и суммы по группам |
Проверка понимания простая: вы можете объяснить, что означает одна строка результата, почему в неё попала конкретная запись и какие записи исключены. Если запрос запускается, но объяснить его результат вы не можете, к следующей теме пока рано.
Учебный пример: клиенты и заказы
Возьмём две небольшие таблицы. Все имена, суммы и статусы вымышлены. Суммы указаны в рублях; в этом примере у каждого заказа один покупатель.
customers — клиенты
| id | name |
|---|---|
| 1 | Анна |
| 2 | Борис |
| 3 | Вера |
orders — заказы
| id | customer_id | status | total |
|---|---|---|---|
| 101 | 1 | new | 1200 |
| 102 | 1 | paid | 2500 |
| 103 | 2 | paid | 1800 |
| 104 | 2 | cancelled | 900 |
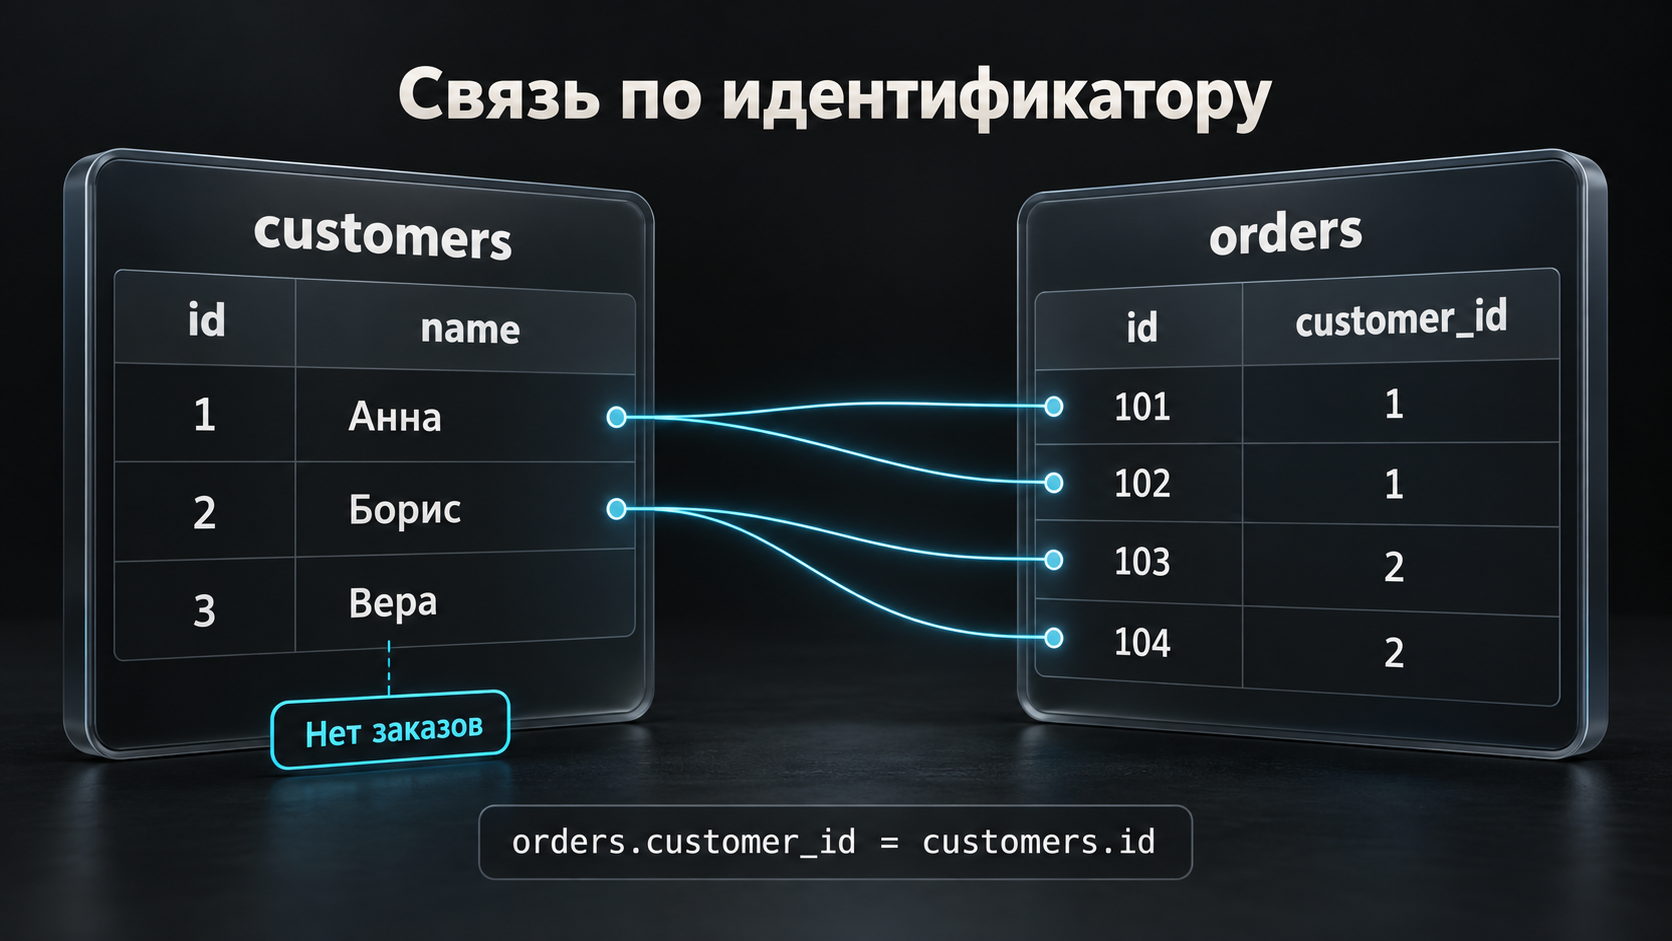
В каждой таблице id — первичный ключ: он однозначно определяет запись. Поле orders.customer_id ссылается на customers.id. Например, заказ 102 связан с клиентом 1 — Анной. У Анны два заказа, у Веры пока ни одного.
Связь строится по идентификатору: имя может совпадать у разных людей и меняться. Поэтому для соединения этих таблиц мы будем использовать customer_id и id.
Примеры ниже написаны в синтаксисе, подходящем для PostgreSQL. Основные конструкции встречаются и в других СУБД, но детали — например, ограничение количества строк и функции дат — могут отличаться.
SELECT и WHERE: выбираем нужные заказы
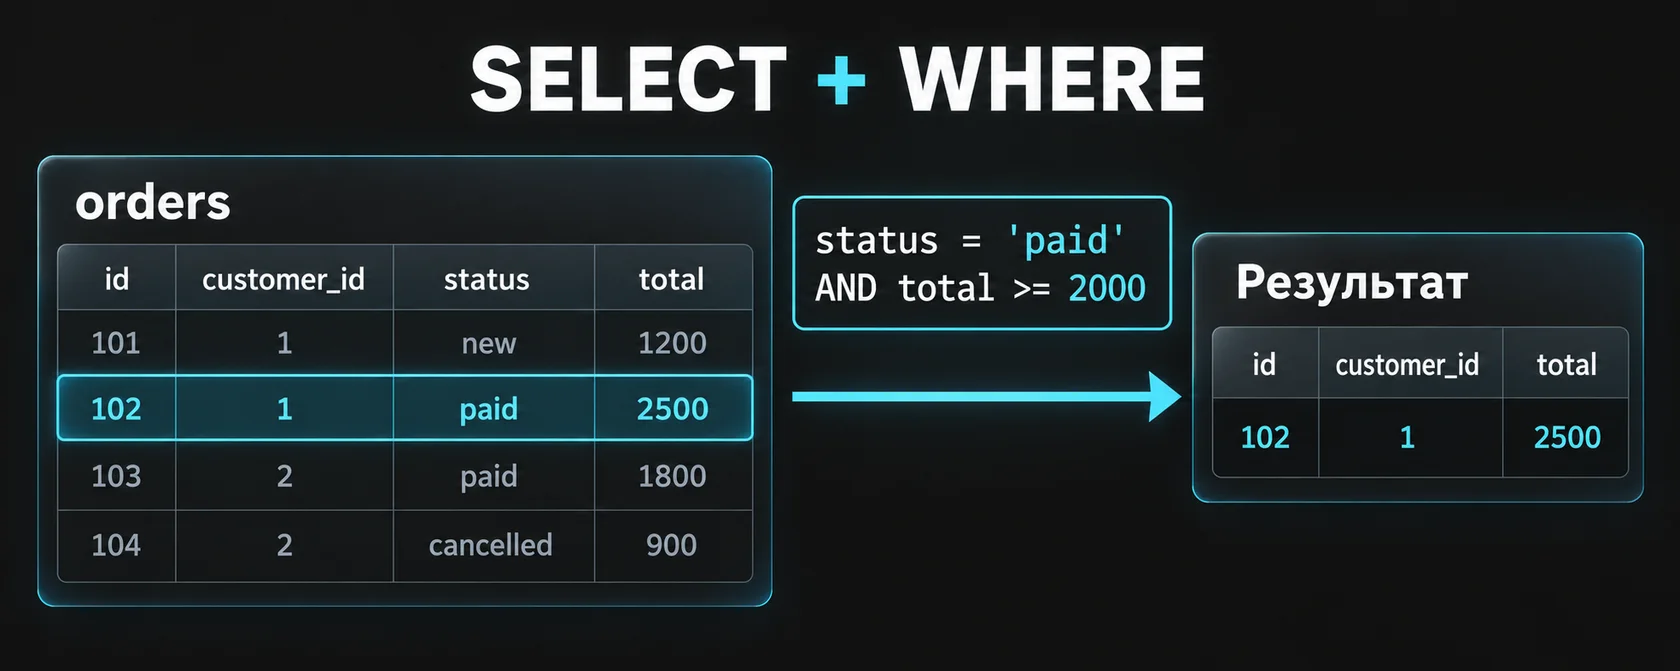
Задача: найти оплаченные заказы на сумму от 2000 ₽ включительно.
SELECT id, customer_id, total
FROM orders
WHERE status = 'paid'
  AND total >= 2000
ORDER BY id;
Прочитайте запрос по частям:
SELECT id, customer_id, total— какие столбцы вернуть.FROM orders— из какой таблицы взять данные.WHERE— какие строки оставить: статусpaidи сумма не меньше 2000.ORDER BY id— в каком порядке показать результат.
Получится одна строка:
| id | customer_id | total |
|---|---|---|
| 102 | 1 | 2500 |
Заказ 103 оплачен, но его сумма меньше порога. Заказ 101 ещё в статусе new. Здесь оба условия должны выполняться одновременно, поэтому нужен AND.
Это небольшой пример SELECT для аналитика: сначала вопрос к данным, затем запрос и объяснение результата. В документации PostgreSQL отдельно разобраны выборка, фильтрация и сортировка.
JOIN простыми словами: добавляем имя клиента
Теперь нужно получить номера оплаченных заказов, имена покупателей и суммы. Статус и сумма находятся в orders, а имя — в customers. JOIN позволяет сопоставить строки двух таблиц по условию.
SELECT o.id, c.name, o.total
FROM orders AS o
INNER JOIN customers AS c
  ON o.customer_id = c.id
WHERE o.status = 'paid'
ORDER BY o.id;
o и c — короткие имена таблиц, или псевдонимы. Запись o.id означает столбец id из orders. Условие после ON указывает, какие строки связать: номер покупателя в заказе должен совпасть с идентификатором клиента.
Результат:
| id | name | total |
|---|---|---|
| 102 | Анна | 2500 |
| 103 | Борис | 1800 |
INNER JOIN оставляет только совпавшие пары. В нашем наборе у каждого заказа есть клиент. Если подходящей строки справа не будет, такой заказ в результат этого соединения не попадёт. Эти правила описаны в учебном разделе PostgreSQL о соединениях.
Почему после JOIN может стать больше строк
Один клиент может соответствовать нескольким заказам. Если убрать из запроса условие WHERE, Анна появится дважды — для заказов 101 и 102. Это ожидаемый результат: одна строка нашей выборки описывает заказ вместе с данными покупателя.
Проблема возникает, когда команда ожидает одну строку на клиента, а получает одну на заказ. Например, при добавлении таблицы позиций заказа один заказ может повториться по числу его позиций. Перед соединением стоит выяснить, сколько записей может соответствовать друг другу. Добавлять DISTINCT только ради исчезновения повторов — плохая замена такой проверке: он может скрыть ошибку в логике выборки.
LEFT JOIN: находим клиента без заказов
Для следующей задачи нужно сохранить всех клиентов, даже если у них нет заказов. Для этого подойдёт LEFT JOIN: он сохраняет строки левой таблицы, а при отсутствии совпадения подставляет NULL в столбцы правой.
SELECT c.id, c.name
FROM customers AS c
LEFT JOIN orders AS o
  ON o.customer_id = c.id
WHERE o.id IS NULL
ORDER BY c.id;
Результат — Вера:
| id | name |
|---|---|
| 3 | Вера |
У неё не нашлось ни одной строки в orders. Поскольку orders.id — первичный ключ и не бывает NULL в существующем заказе, проверка o.id IS NULL здесь выделяет именно отсутствие совпадения.
NULL обозначает отсутствие значения. Его нельзя проверять условием = NULL: для такой проверки используют IS NULL или IS NOT NULL. Подробнее — в документации PostgreSQL об операторах сравнения.
Обратите внимание: «нет заказов» и «нет оплаченных заказов» — разные условия. Во втором случае нужно учитывать статус уже при поиске совпадения. Перенос фильтра между ON и WHERE после LEFT JOIN может изменить результат; этот нюанс разобран в разделе о табличных выражениях.
COUNT, SUM и GROUP BY: считаем результат
Посчитаем, сколько оплаченных заказов у каждого покупателя и на какую сумму:
SELECT customer_id,
       COUNT(*) AS order_count,
       SUM(total) AS total_amount
FROM orders
WHERE status = 'paid'
GROUP BY customer_id
ORDER BY customer_id;
Результат:
| customer_id | order_count | total_amount |
|---|---|---|
| 1 | 1 | 2500 |
| 2 | 1 | 1800 |
WHERE оставляет оплаченные заказы, GROUP BY собирает строки по покупателю, COUNT(*) считает строки каждой группы, а SUM(total) складывает суммы. Эти конструкции позволяют проверить число записей и итоговую сумму без ручного подсчёта. Документация PostgreSQL об агрегатных функциях показывает тот же принцип на другом наборе данных.
Веры в результате нет: запрос начинается с таблицы заказов, а её заказов там нет. И ещё одна деталь для следующего шага: COUNT(*) считает строки, а COUNT(поле) — только строки, где значение этого поля отличается от NULL. Числовой ноль при этом считается обычным значением. После LEFT JOIN это различие особенно важно. (Описание COUNT)
Как связать SQL с требованиями к системе
Вернёмся к личному кабинету. Правило для учебного примера можно сформулировать так: «Показывать заказы текущего пользователя со статусом paid; для каждого заказа выводить номер и сумму».
Теперь у аналитика есть вопросы для обсуждения:
- Считается ли частично оплаченный заказ оплаченным?
- Как показывать возврат или отмену после оплаты?
- Какие данные получит пользователь без оплаченных заказов?
- Как система проверит, что заказ принадлежит текущему пользователю?
SQL помогает проверить выборку на подготовленных данных. При этом сам запрос из статьи ещё не реализует личный кабинет: в нём нет фильтра текущего пользователя и проверки его прав. Данные для интерфейса может отдавать отдельный сервис через API. Как устроен такой обмен, разбираем в статье «API простыми словами».
Чего не нужно учить первым
Для разобранных задач не требуется начинать с настройки серверов БД, репликации или сложных хранимых процедур. Сначала закрепите простые выборки и соединения. Следующими темами могут стать подзапросы, CASE, HAVING, работа с датами, оконные функции и чтение плана выполнения — по мере появления задач.
Практикуйтесь на учебной базе. Доступ к рабочим данным, ограничения на запросы и допустимую нагрузку согласуют с командой. Даже запрос на чтение может оказаться тяжёлым. В PostgreSQL LIMIT ограничивает число возвращаемых строк, но сам по себе не гарантирует дешёвое выполнение всего запроса; без ORDER BY выбранный фрагмент также не имеет гарантированного порядка. (LIMIT и OFFSET, описание SELECT)
Небольшое упражнение для самостоятельной проверки
На тех же двух таблицах попробуйте:
- Найти все заказы Анны с номерами, статусами и суммами, упорядочив по номеру заказа.
- Показать оплаченные заказы дешевле 2000 ₽ вместе с именами покупателей.
- Посчитать количество заказов в каждом статусе.
Ожидаемый результат: в первом задании — заказы 101 и 102; во втором — заказ 103 Бориса на 1800 ₽; в третьем — new: 1, paid: 2, cancelled: 1.
Для каждого запроса объясните, что означает строка результата. Затем измените одно исходное значение и предскажите, что поменяется в ответе. Такой способ помогает освоить SQL с нуля: вы проверяете понимание, а не только запоминаете команды.
Как выбрать SQL-курс для аналитиков
Если вы выбираете курс SQL для аналитиков, смотрите на практику: есть ли связанные таблицы, задания с проверкой результата, разбор NULL и объяснение повторов после JOIN. Для системного аналитика полезны упражнения, в которых запрос связан с правилом продукта: какие заказы показать, какие записи исключить и почему.
Отдельный SQL-курс закрывает работу с запросами. Для перехода в системный анализ нужна и остальная база: требования, модели данных, процессы и интеграции. В программе Prosystalent SQL изучается вместе с этими темами. Обучение рассчитано на 6 недель, после подготовки команда сопровождает поиск работы. Предоплата — 0 ₽; после официального выхода на работу предусмотрена оплата 20% от дохода в течение 12 месяцев по условиям договора. Изучите условия оплаты и оставьте заявку, если хотите обсудить программу и свой старт.
Частые вопросы
Какой SQL нужен системному аналитику?
Для первых учебных задач начните с SELECT, фильтрации, сортировки, INNER JOIN, LEFT JOIN и простых агрегатов. Важно также понимать ключи, связи таблиц и NULL. Более глубокий набор определяется задачами команды и требованиями вакансии.
Можно ли изучать SQL без опыта программирования?
Да. Можно начать с маленьких таблиц и запросов на чтение. Сначала сформулируйте вопрос обычными словами, затем запишите запрос и сравните ответ с исходными данными. Для примеров этой статьи навыки разработки приложения не нужны.
Чем INNER JOIN отличается от LEFT JOIN?
INNER JOIN возвращает совпавшие пары строк. LEFT JOIN сохраняет все строки слева; если совпадения справа нет, соответствующие правые столбцы содержат NULL. Выбор зависит от того, нужно ли видеть записи без соответствия.
Достаточно ли знать только SELECT?
Одной простой выборки из таблицы недостаточно для всех задач. Вместе с ней полезно освоить условия, соединения, группировку и проверку результата. Запросы на изменение данных изучают отдельно; запускать их в рабочей базе без согласования не следует.
Что выбрать для начала — PostgreSQL или MySQL?
Для этой статьи выбрана PostgreSQL, чтобы примеры и документация опирались на одну СУБД. Если вы учитесь под конкретный проект, начинайте с его системы. После базовых конструкций отдельно изучите различия синтаксиса и поведения выбранных СУБД.